|
|
爱科技、爱创意、爱折腾、爱极致,我们都是技术控
您需要 登录 才可以下载或查看,没有账号?立即注册
x
凤凰网科技讯 9月23日,千问今日正式发布Qwen-Audio-3.1系列语音大模型,对语音识别、语音合成和实时语音交互三大核心模型进行全面升级,同时推出全新的音频创作模型Qwen-Audio-3.1-TTS-Next和音频理解模型Qwen-Audio-3.1-ASR-Next。官方称,五款新模型形成覆盖“理解-生成-交互-创作”的完整音频能力栈。为进一步降低使用成本,Qwen-Audio全线语音模型价格均下调,其中TTS降价约70%,Realtime降幅约85%,ASR降幅达95%。
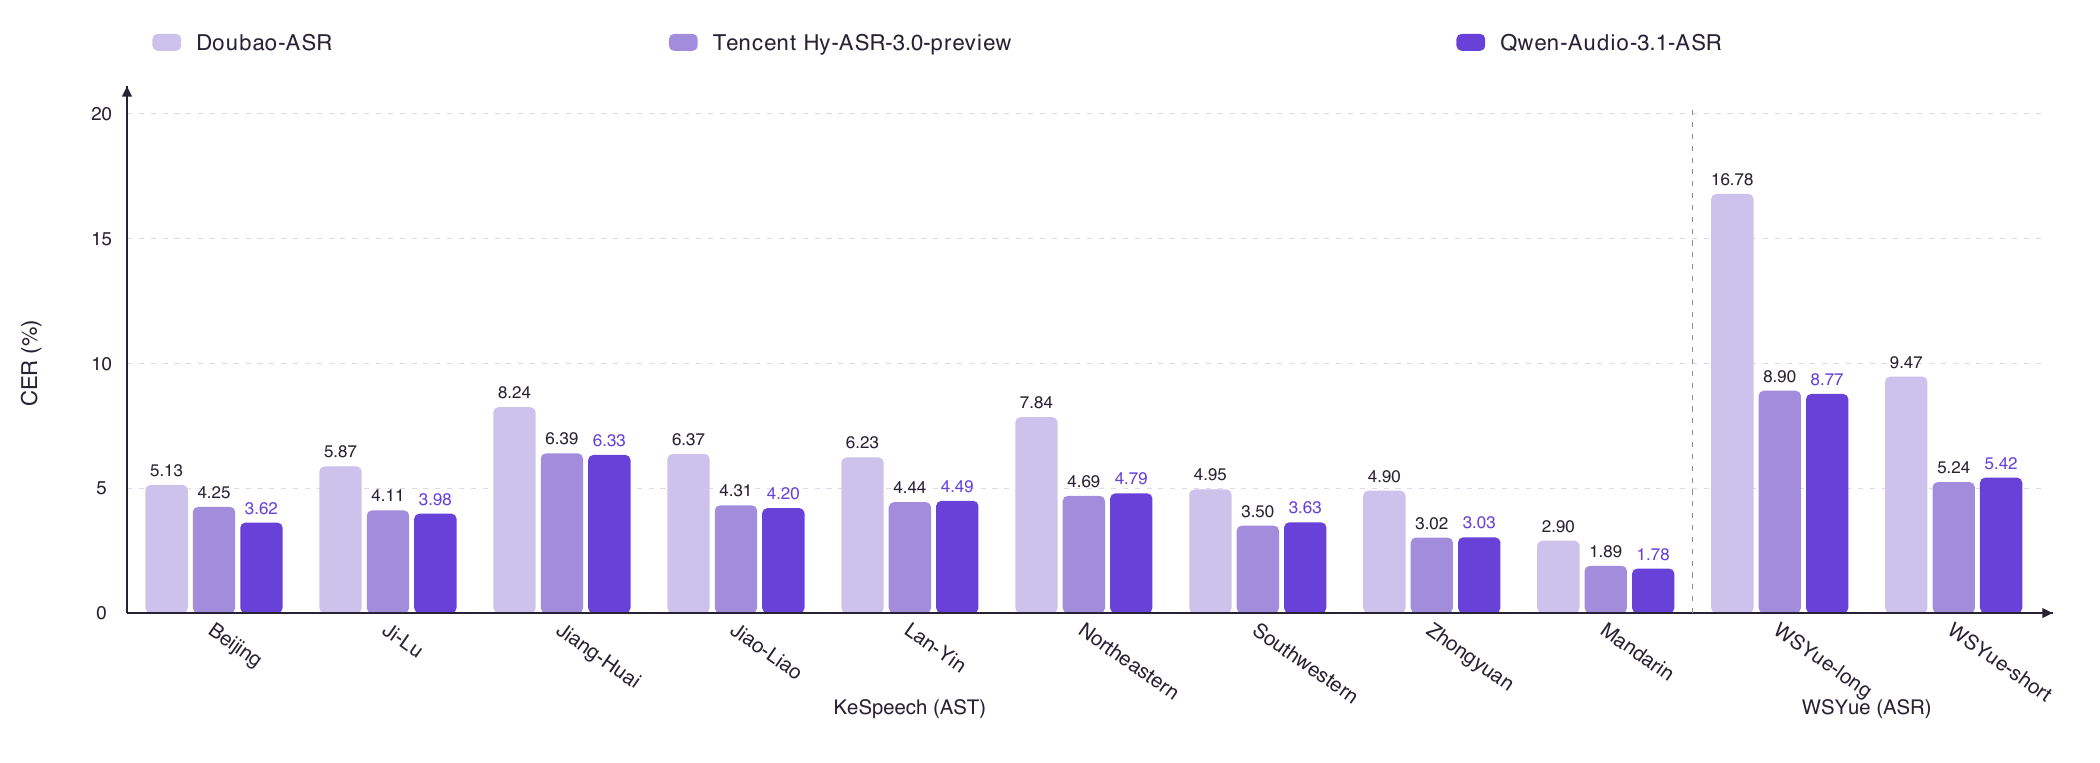
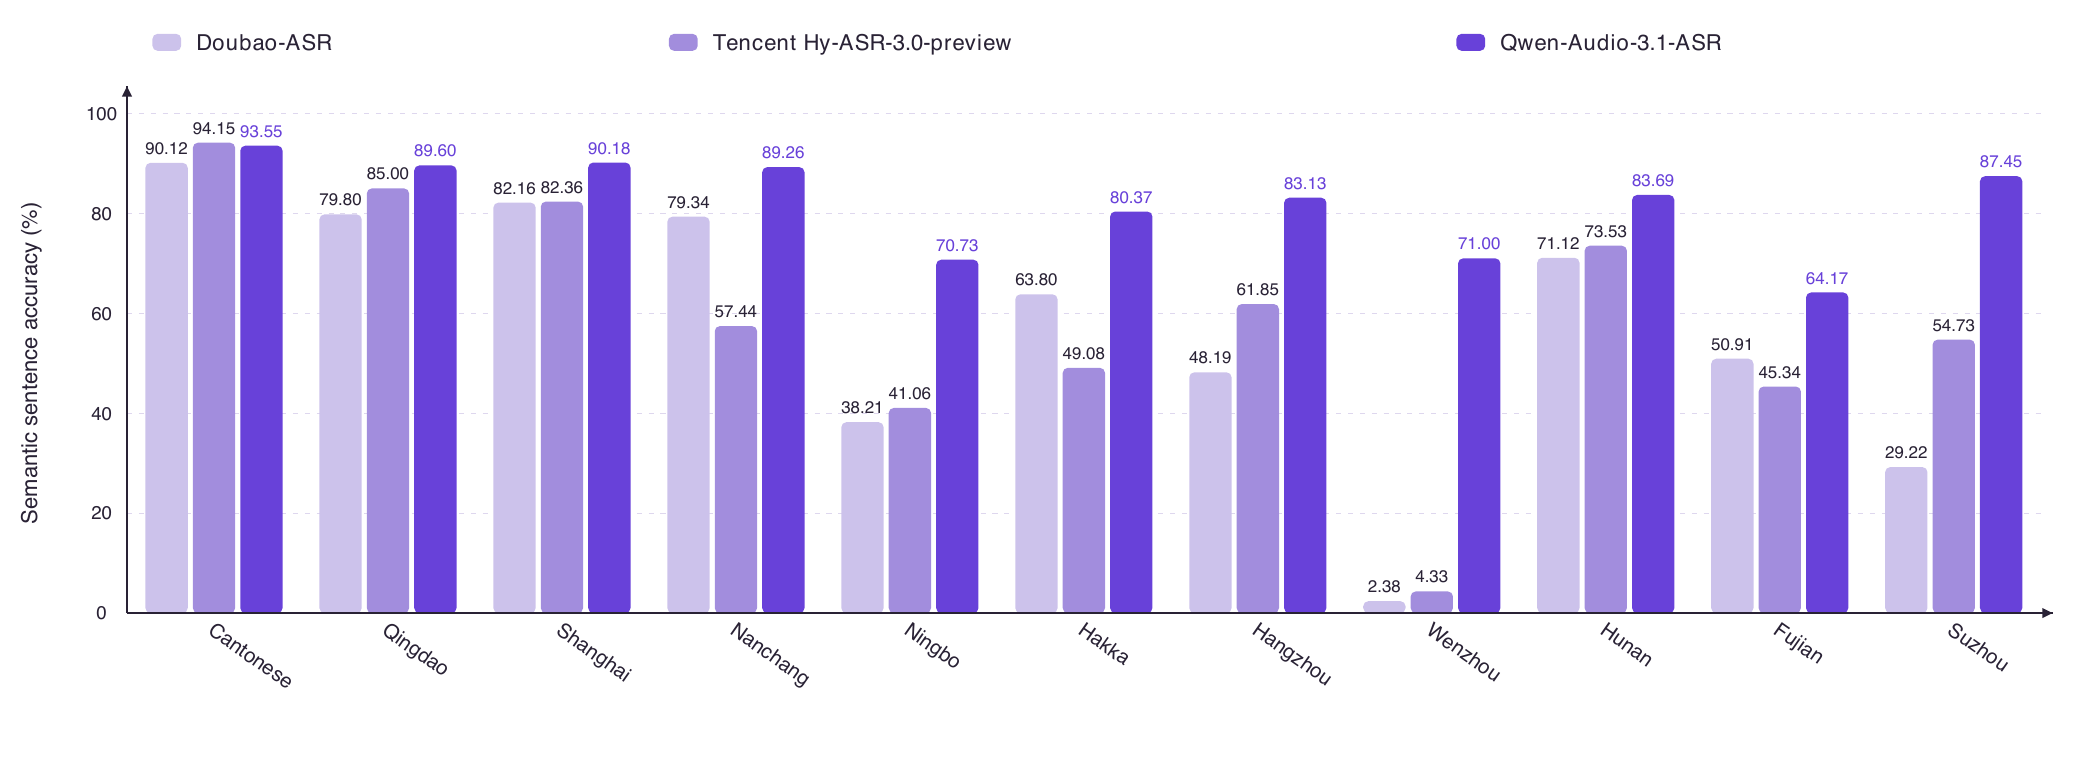
Qwen-Audio-3.1-ASR进一步增强多语种、方言识别与上下文理解能力,新增原生转写润色功能,可自动去除语气词与重复表达并重组语义。该模型一套支持30种语言和16种中文方言,支持低延迟流式识别,首字响应约160毫秒。在中文方言内部测试集上,其平均CER为10.38%,在11个方言子集上取得最优结果,温州话等较难方言提升尤为明显。
Qwen-Audio-3.1-ASR-Next基于下代架构,能够理解人物情绪、环境声与机械声,完成声音描述、事件定位、音频问答与推理。ASR处理的对象从“语音中的文字”扩展为“完整的音频信息”。在分角色ASR评测中,该模型在四个测试集的八项指标中取得五项最优结果。
Qwen-Audio-3.1-TTS支持多语种及方言合成,并支持同一音色跨语言合成时的自然迁移,同时可通过指令控制情绪、语速和表达方式。
Qwen-Audio-3.1-TTS-Next是全新的音频创作模型,不再局限于单一语音合成,而是围绕文本、时间戳和参考音频等输入,统一生成人声、音效和环境音。该模型支持多角色音色复刻与多轮对话生成,融合人声、音效与环境声,并可通过自然语言控制生成过程,支持细粒度时间戳控制和48kHz输出,覆盖播客、有声书、影视剧、游戏、广告等专业音频创作需求。
Qwen-Audio-3.1-Realtime升级全双工实时交互能力,可同时说和听,支持随时插话、打断。模型能够识别用户情绪与交流意图,在对话中切换语言时保持上下文与语气,并可主动调用Agent工具完成搜索、查询或任务执行。目前,Qwen-Audio-3.1-Realtime正在与Qoder、千问办公等Agent,以及QwenNote、A2、Eva、千问AI眼镜、乐奇AI眼镜等智能硬件结合。
|
|


 IP归属地
 雷达卡
 发表于
 提帖卡
 置顶卡
 锁帖卡
 解锁卡
 显目卡
 千斤顶